多くの企業が生成AIを活用して、業務用チャットボットを開発しています。近年 LLM(大規模言語モデル)の性能が全体的に底上げされたこともありますが、AIに企業のデータを学習させるさまざまな方法が登場したことも理由です。
かつては Fine Tuning 方式で大量のデータ入力と手作業が必要でしたが、最近は RAG(Retrieval-Augmented Generation)を活用すれば、データを学習した業務用チャットボットを簡単に作れるようになりました。
RAG の原理はシンプルです。基本的に2つの要素で構成されます。
RAG は、LLM の学習の限界や、時間の経過に伴う情報更新の問題を解決するのに役立ちます。基本的に、LLM が最新のデータや企業内部の機密資料などを活用したカスタマイズ済みの応答を提供できるよう支援します。
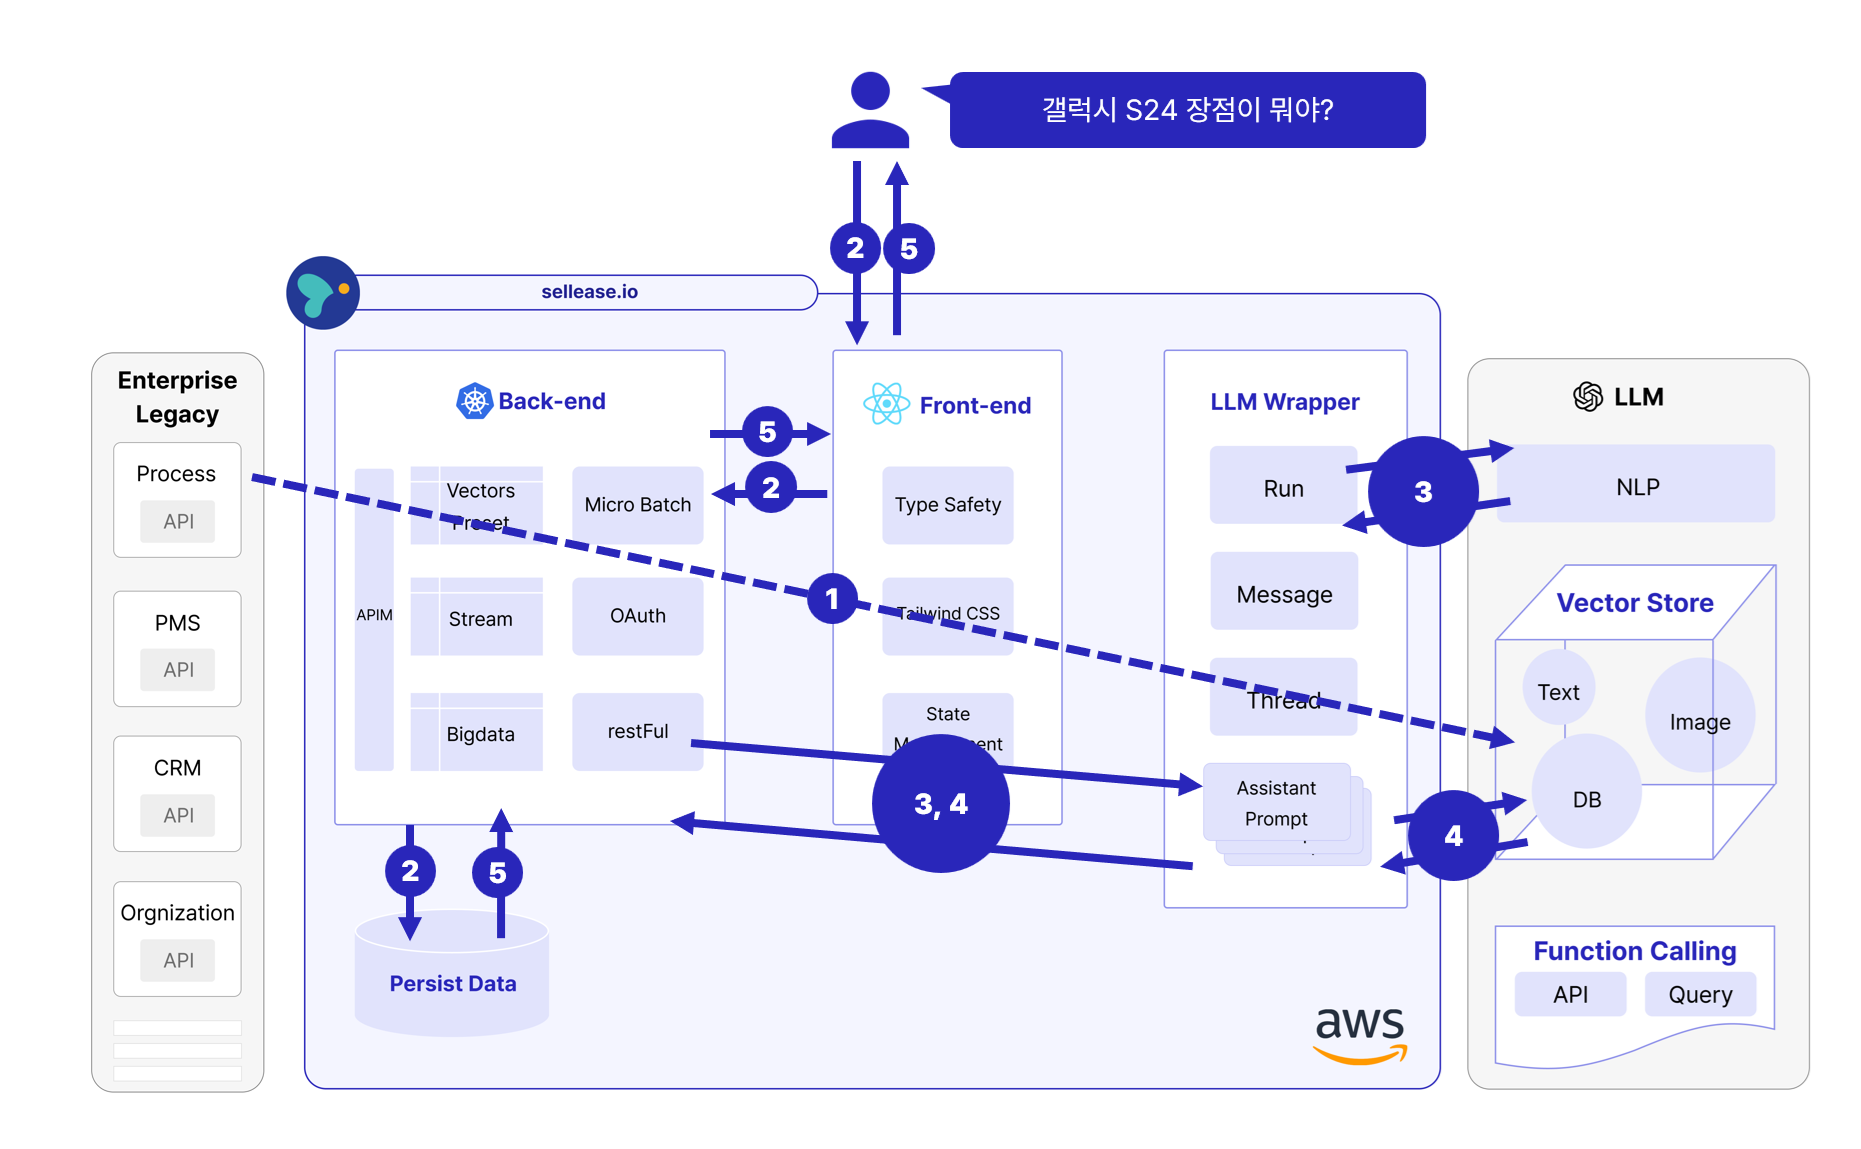
1. Vector Store にデータを入力
2. ユーザーの質問を受信
-> ユーザーのコンテキストを保存・参照
3. 質問の分析
-> AI はユーザーから入力された命令や質問を自然言語処理(NLP)で分析します。たとえば「Galaxy S24 の長所は?」という命令があると、AI は製品情報を検索する関数が必要だと理解します
4. 情報の検索
-> 質問をベクトルに変換したうえで、事前に入力された Vector Store から、コサイン類似度などをもとに関連性の高い情報を探します(学習データの品質によってはハルシネーションが起こりえます)
5. 結果の返却
-> 質問の意図に合わせて回答を自然にまとめ、プロンプトに沿って回答します
RAG を活用してさまざまなリサーチを行いました。多くの企業が RAG を導入してチャットボットを開発しており、私たちもこの技術を積極的に活用しようとしました。しかし特定の環境では、RAG は次のような限界を示しました。
RAG のエージェントを分離し、プロンプトを最適化するなど複数の手順を踏みましたが、ある時点からそれ以上は回答の信頼性が向上しなくなりました。そこで別の方法を探し、その解決策が Function Calling でした。
Function Calling は、RAG の限界を克服できるさまざまな利点を提供します。
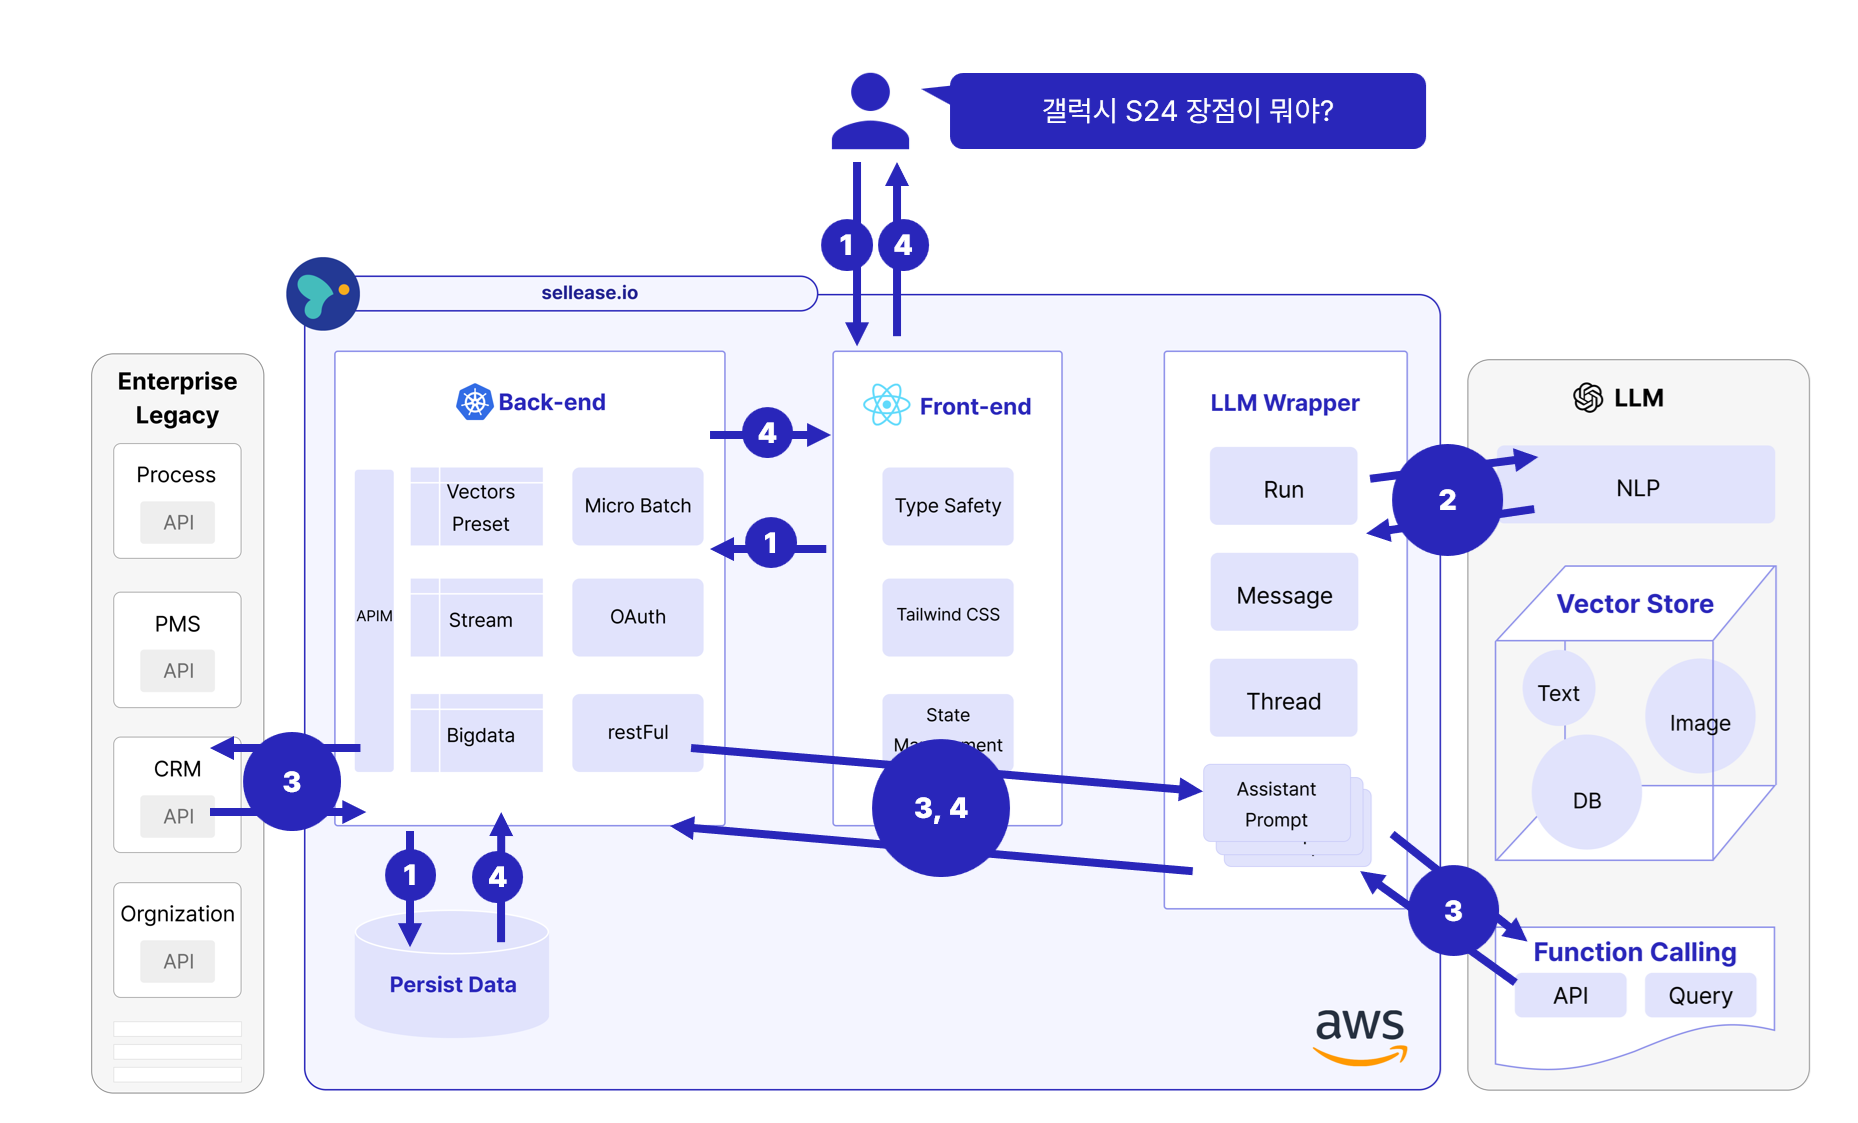
1.ユーザーの質問を受信
-> ユーザーのコンテキストを保存・参照
2.質問の分析
-> AI はユーザーから入力された命令や質問を自然言語処理(NLP)で分析します。たとえば「Galaxy S24 の長所は?」という命令があると、AI は製品情報を検索する関数が必要だと理解します
3.関数の呼び出し
-> 命令を分析したあと、その作業を処理できる関数(または API)を呼び出します。このとき関数は、あらかじめ定義された命令とパラメータに基づいて呼び出されます。例)ニュースルームの Search API で Galaxy S24 を検索
(検索された結果を返すのでハルシネーションなし)
4.結果の返却
-> 関数が実行されたら、その結果をユーザーが理解できる形で再び提供します
例)取得した情報から Galaxy S24 の長所だけを抜き出して回答(このときプロンプトエンジニアリングが適用されます)
企業向けAIエージェントを構築する際は、RAG と Function Calling の機能を適切に組み合わせることが重要です。その理由は、企業のすべてのデータがシステム上に存在するわけではなく、API で呼び出せない情報も多いからです。たとえば、企業の規定のように単一の事実として存在するデータは、RAG のほうが効率的です。
一方、営業、物流、管理など、リアルタイムで変化するビジネスプロセスのデータは、Function Calling を活用して処理する必要があります。
RAG と Function Calling を効果的に組み合わせてAIエージェントを構築すれば、企業環境でより信頼でき、効率的なAIソリューションを作れます。